WHY Q-OCR
Q-OCR의
특별함
GS인증 1등급을 받은 Q-OCR은 글자만 옮기지 않고 문서의 구조까지 읽습니다.
-
01
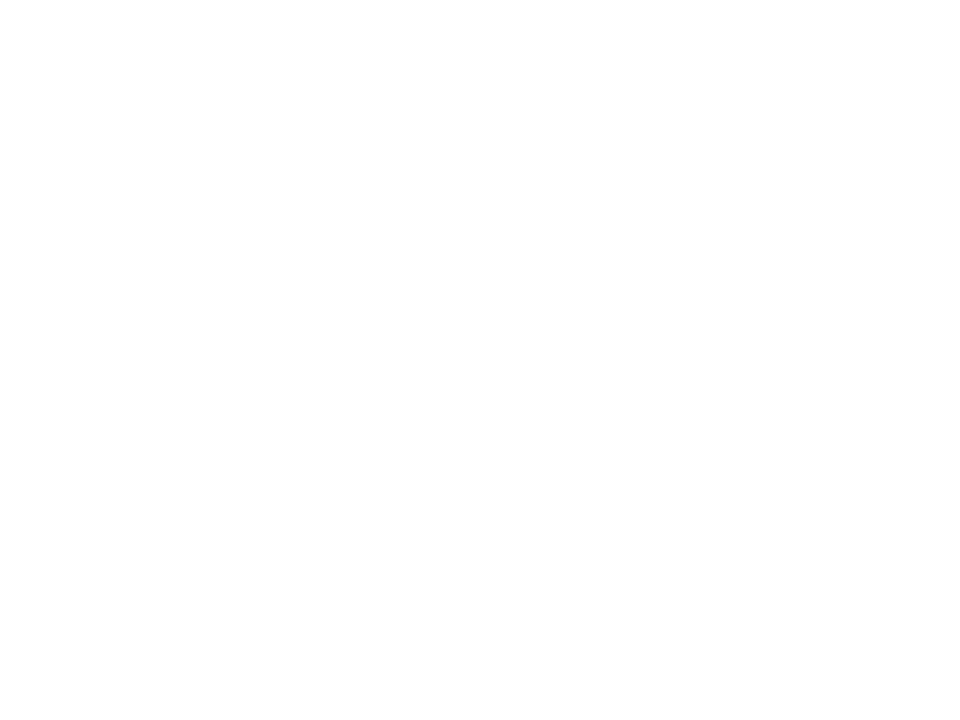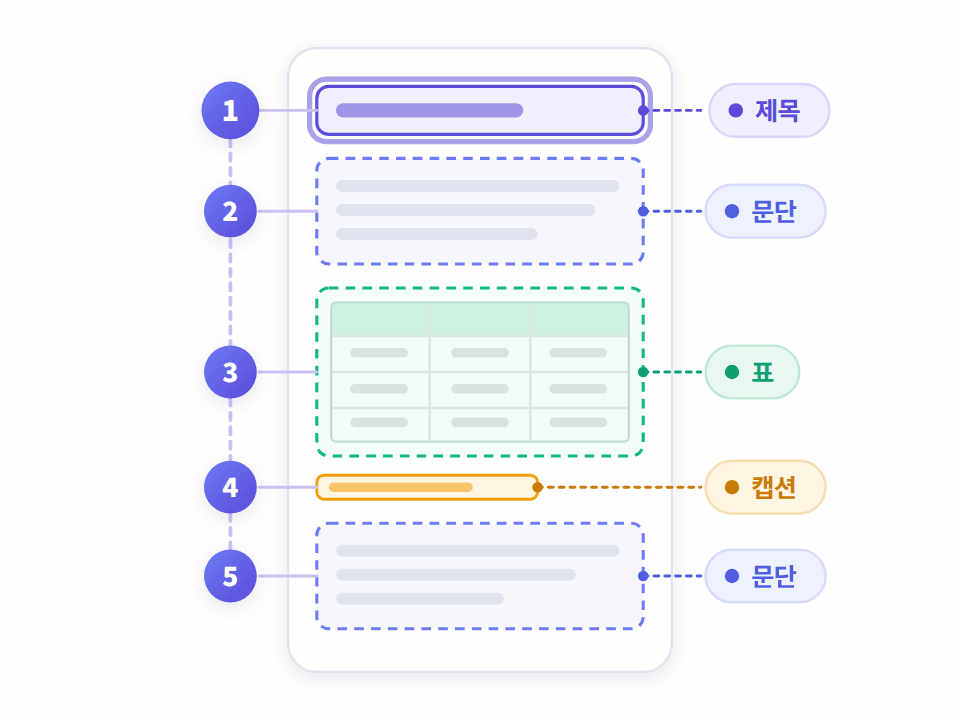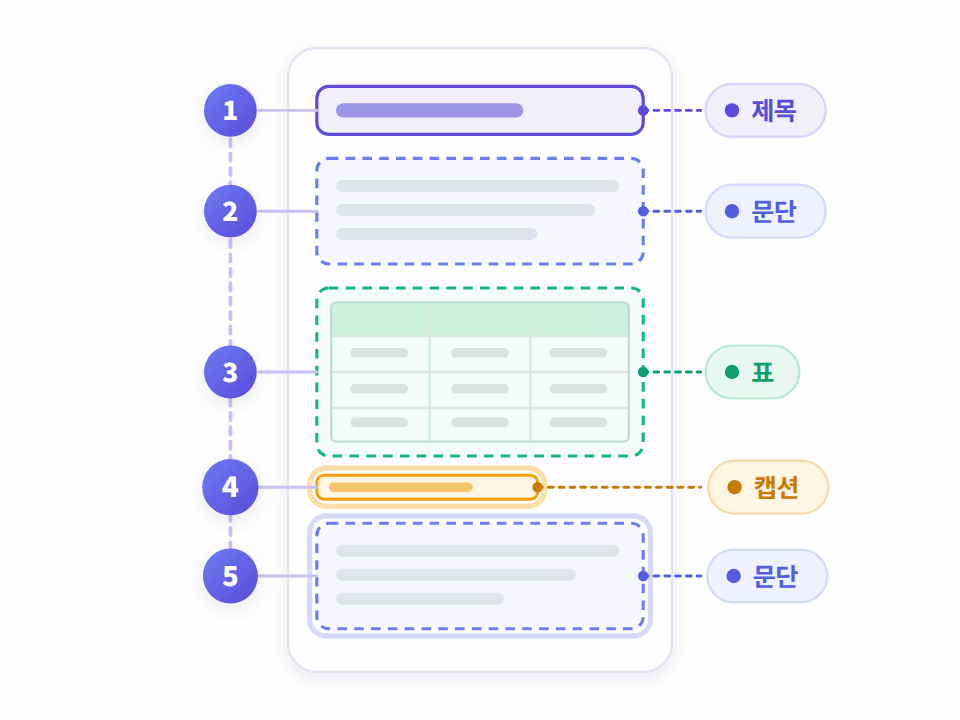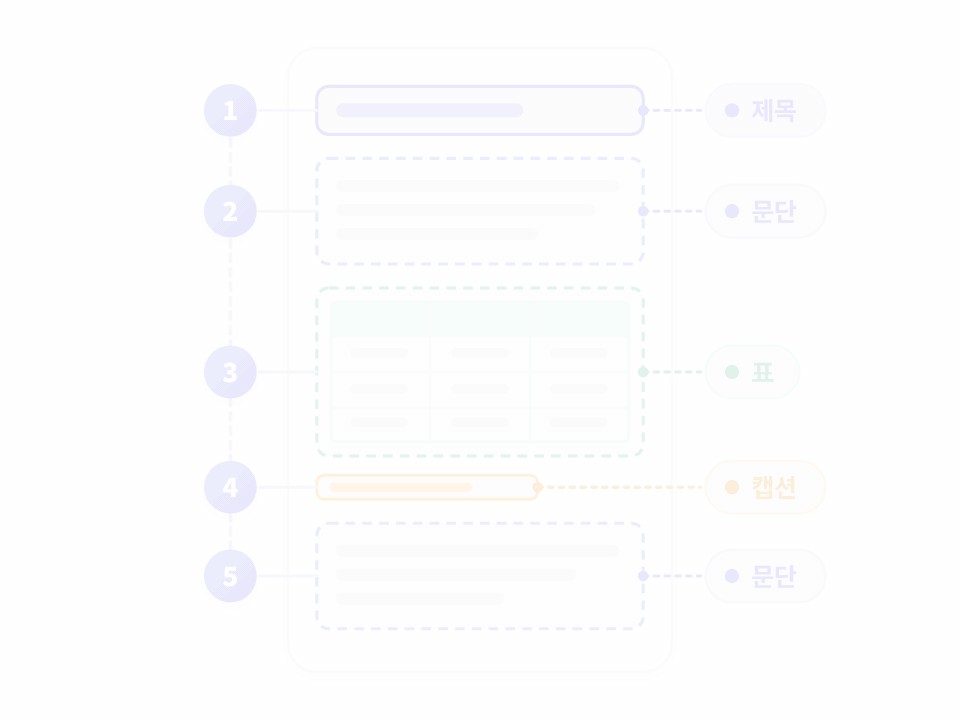
문서 구조 인식
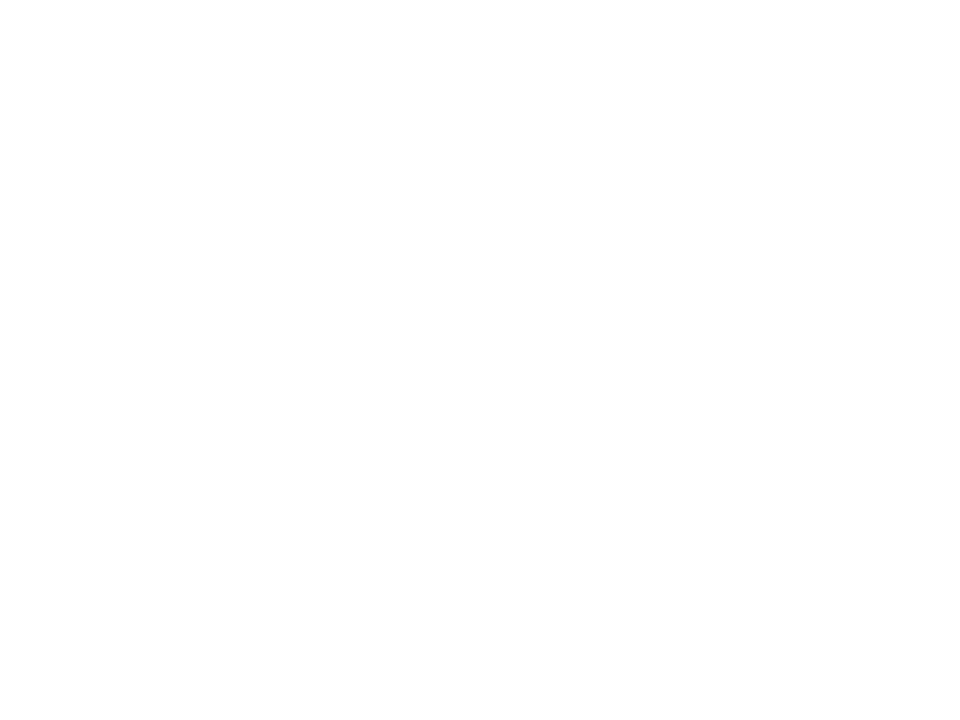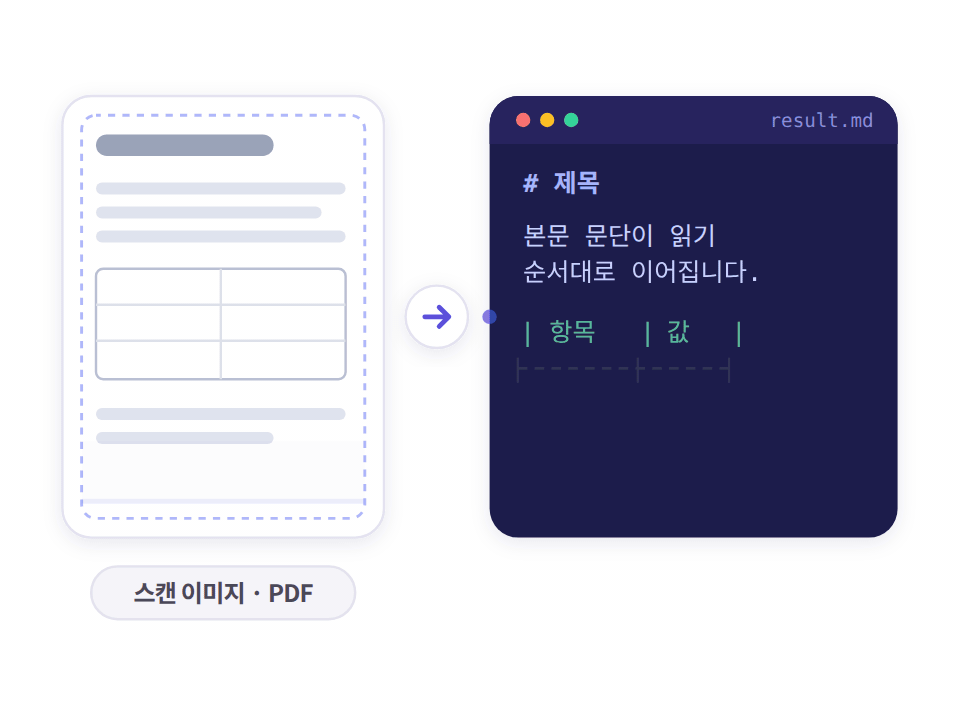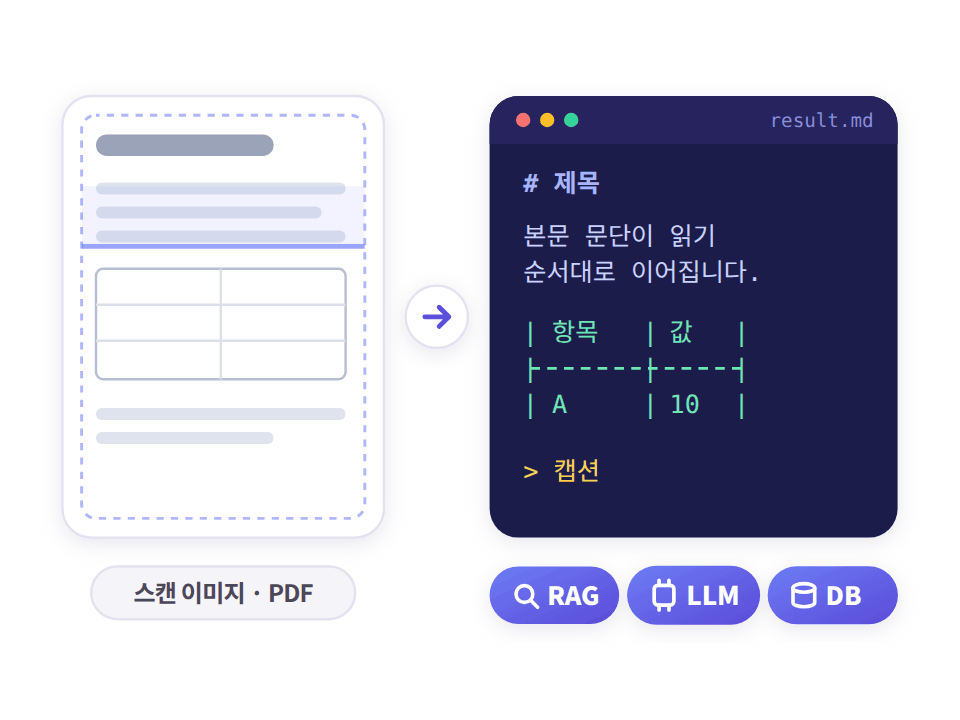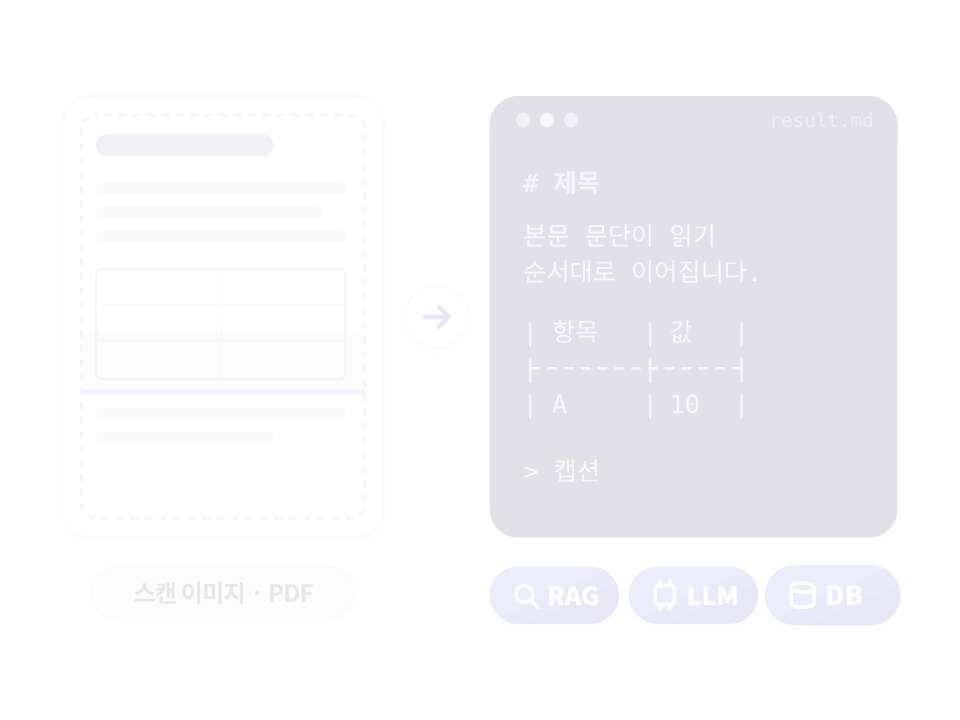
제목·문단·표·캡션과
읽기 순서까지 그대로제목·문단·머리글·바닥글·캡션·목차·표를 영역별로 나누고, 사람이 읽는 순서대로 읽기 순서를 구성합니다. 글자만 옮기는 OCR과 달리 문서의 짜임새가 그대로 남습니다.
-
02
정확한 표 인식
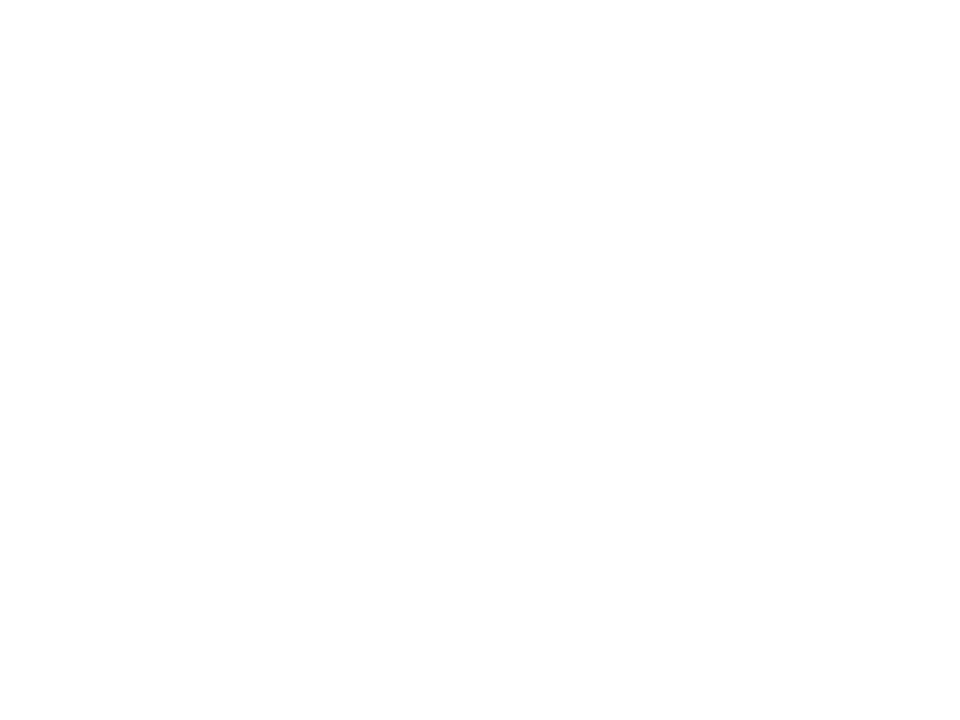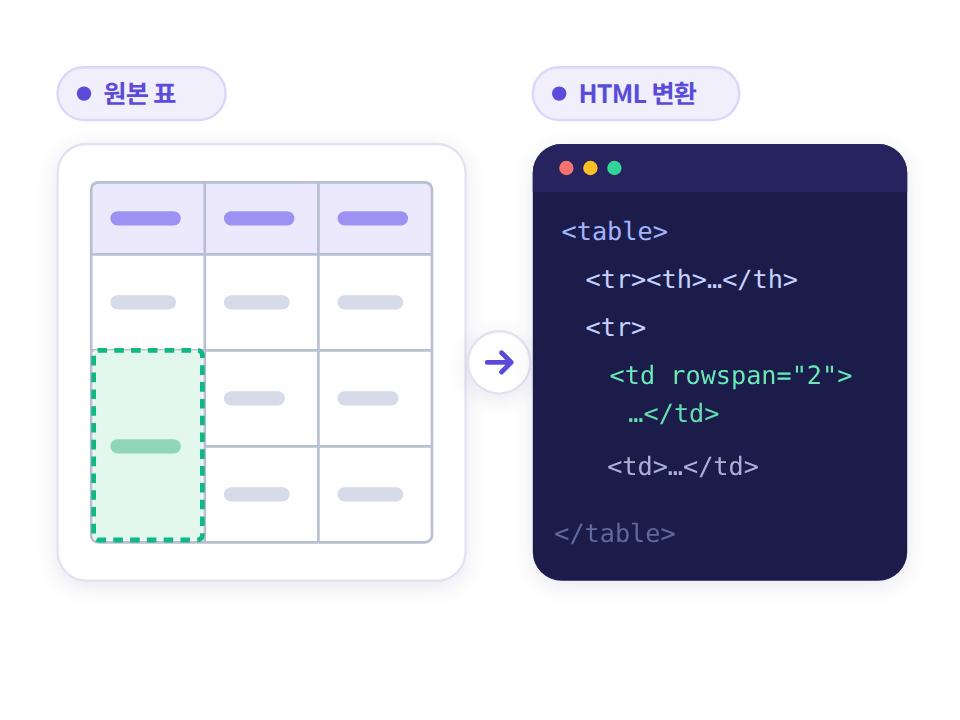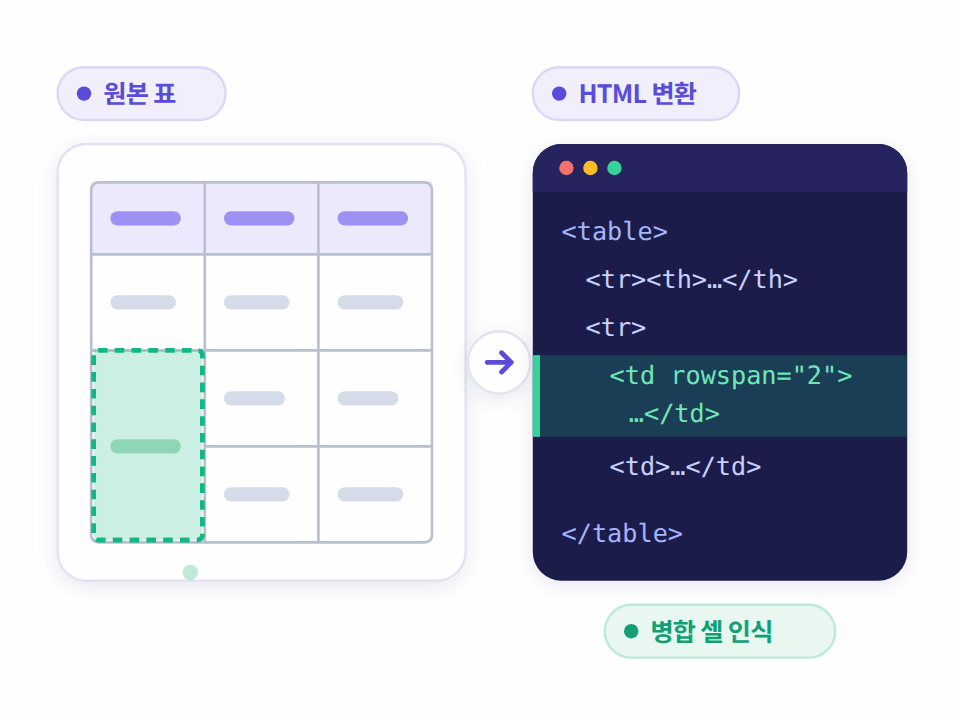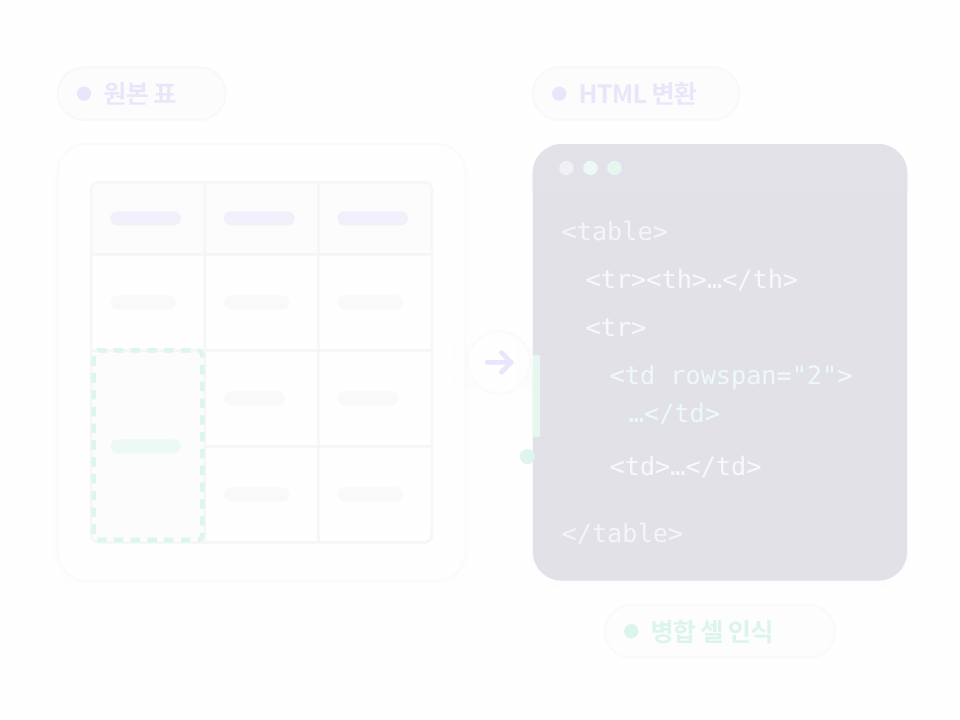
병합 셀까지 살린
표 구조를 그대로 변환표의 행·열과 병합 셀을 분석하고 텍스트 인식 결과와 결합해 HTML로 변환합니다. 별도 가공 없이 데이터베이스 구축과 업무 자동화에 바로 씁니다.
-
03
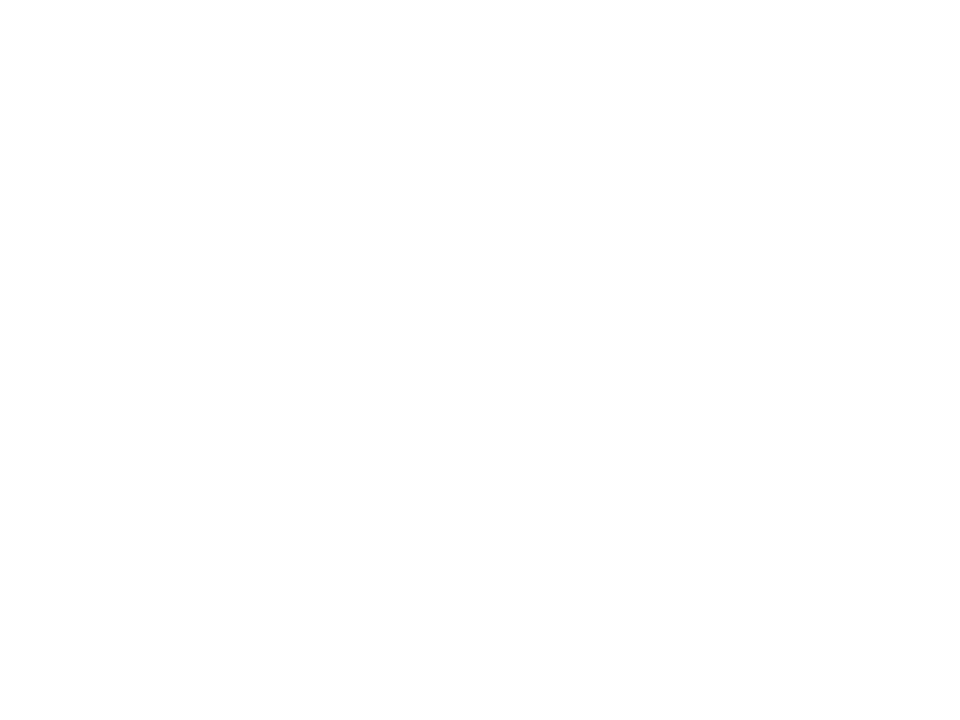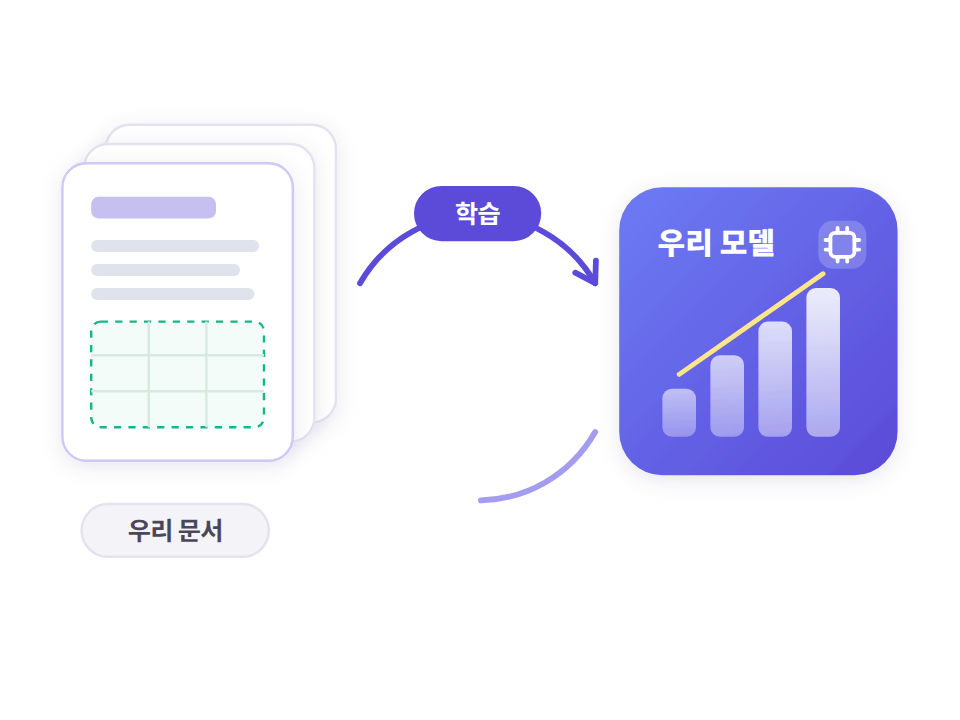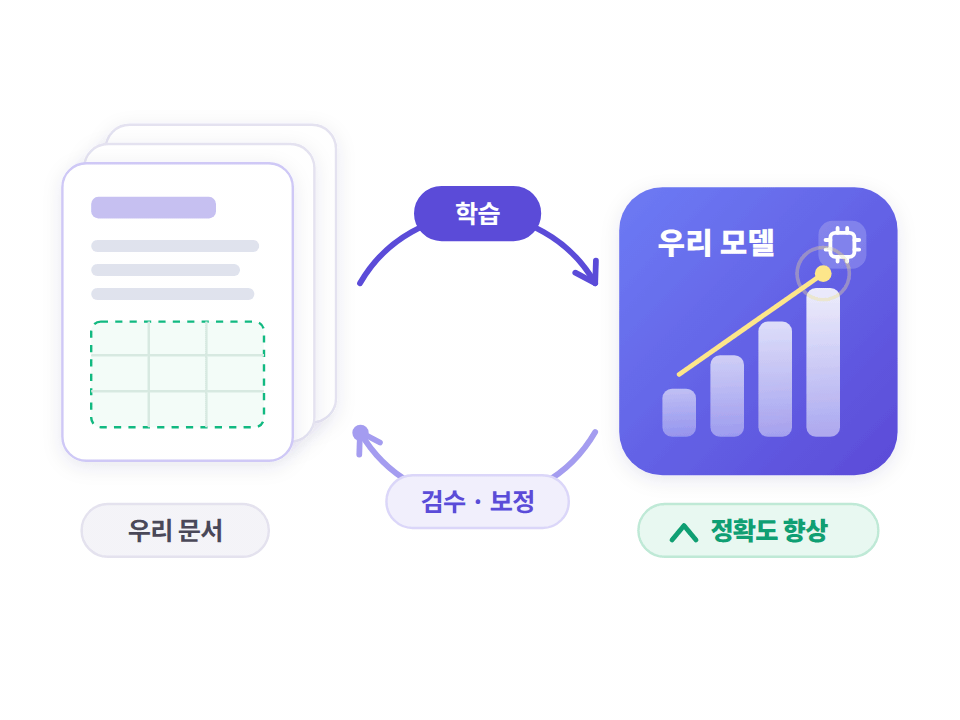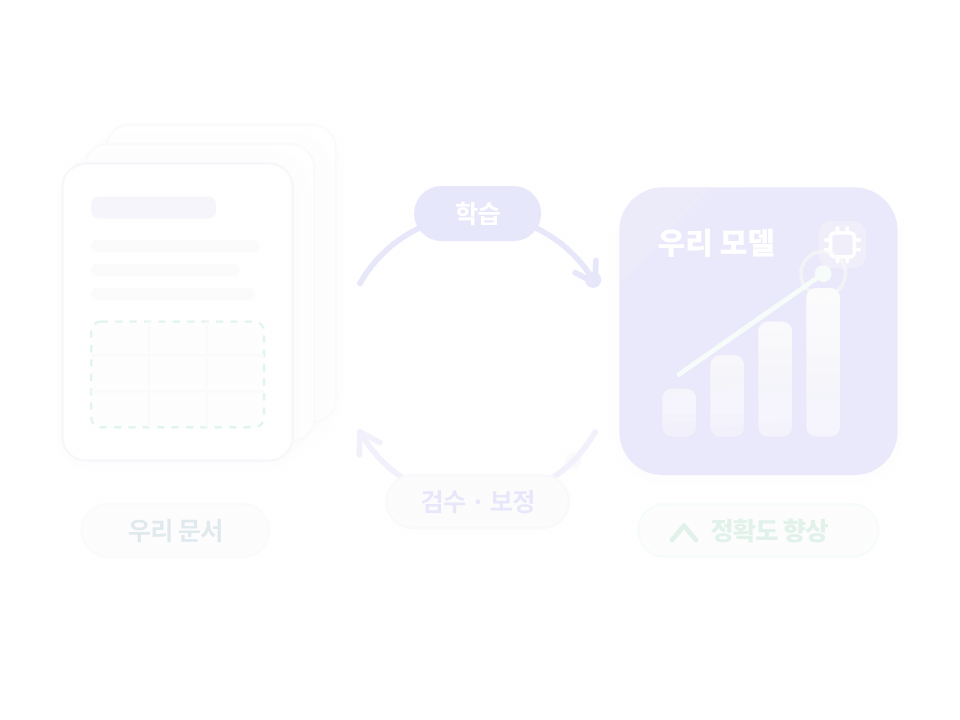
우리 문서 맞춤 학습
우리 문서로 학습시켜
정확도를 높이는 OCR라벨링 도구로 우리 문서에 맞는 학습 데이터를 직접 만들고 모델을 추가 학습시킵니다. 검수와 보정을 거칠수록 인식 정확도가 올라갑니다.
-
04
AI 활용 형식
RAG·LLM이 바로 쓰는
Markdown으로 출력인식 결과를 구조가 살아 있는 Markdown으로 내보냅니다. RAG 답변, LLM 학습·추론, 데이터베이스 구축에 추가 변환 없이 연결됩니다.
ARCHITECTURE
기술 구성도
오피스 문서와 이미지 문서를 함께 분석해 레이아웃·표·텍스트를 인식하고, Markdown으로 구조화한 결과를 LLM 학습·추론, 대화형 AI 문답, 업무 자동화, 데이터베이스 구축에 활용합니다.
FEATURES
주요 기능
인식부터 학습 데이터 구축, 모델 학습, 운영까지 하나의 시스템에서 처리합니다.
-
01
문서 구조 인식
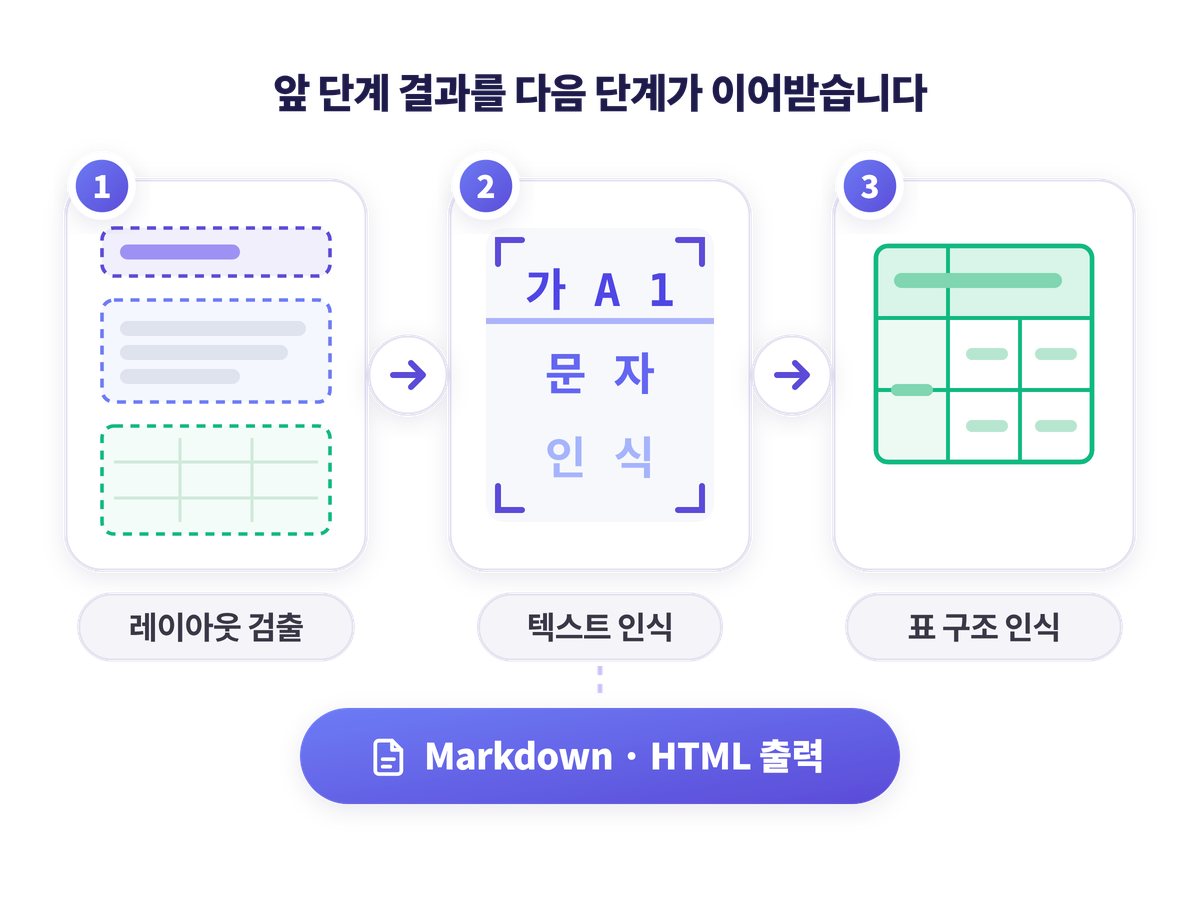
레이아웃 검출, 텍스트 인식, 표 구조 인식이 앞 단계의 결과를 이어받아 한 흐름으로 처리됩니다.
- 제목·문단·머리글·바닥글·캡션·목차·표 등 구성 요소를 영역별로 구분
- 사람이 읽는 순서대로 읽기 순서 구성
- 표의 행·열과 병합 셀을 분석해 HTML로 변환
- 인식 결과를 Markdown 형태로 출력
-
02
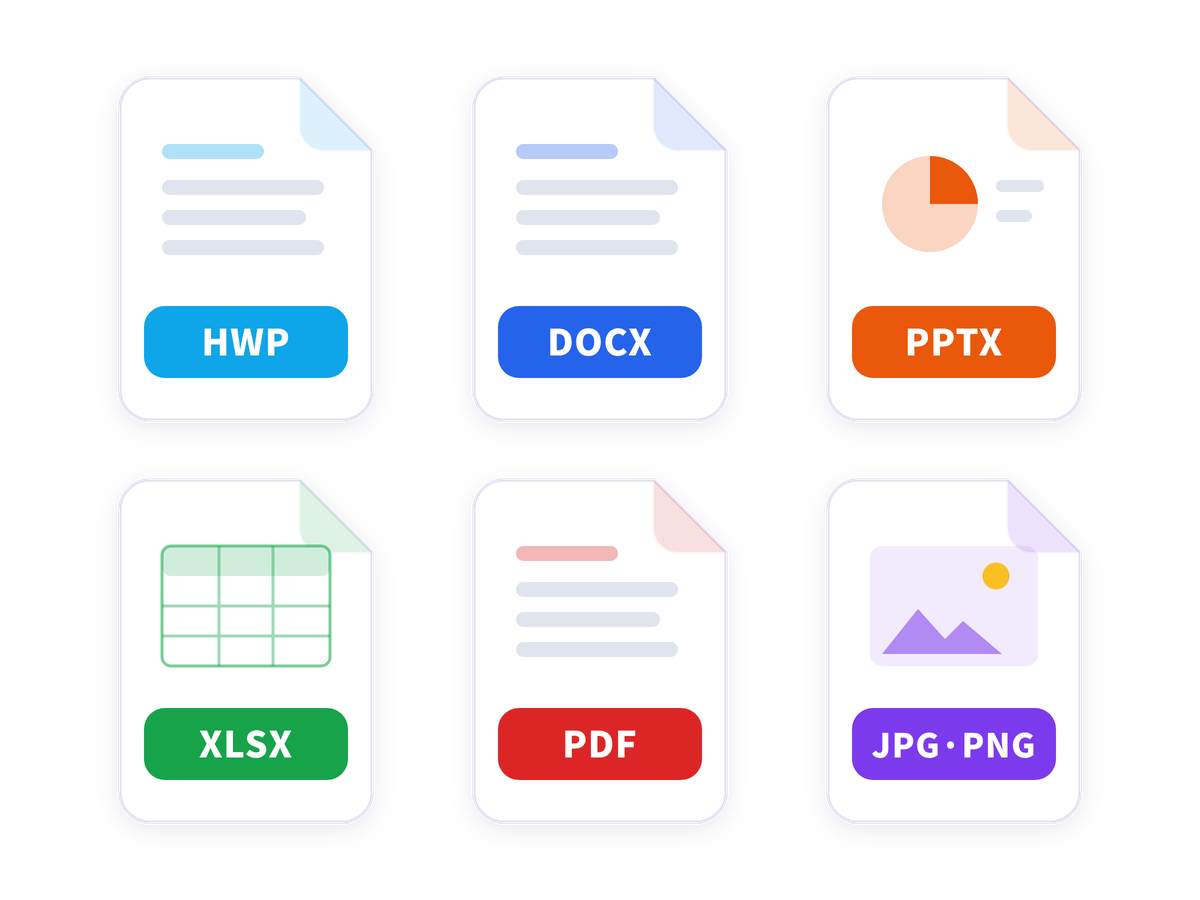
다양한 문서 포맷 지원
업무 현장에서 쓰는 문서를 형식에 맞춰 분석합니다.
- 한글·워드·파워포인트·엑셀 등 오피스 문서
- PDF와 PNG·JPG 등 이미지 문서, 스캔본
- 오피스 문서는 포맷 분석, 이미지 문서는 이미지 분석으로 처리
-
03
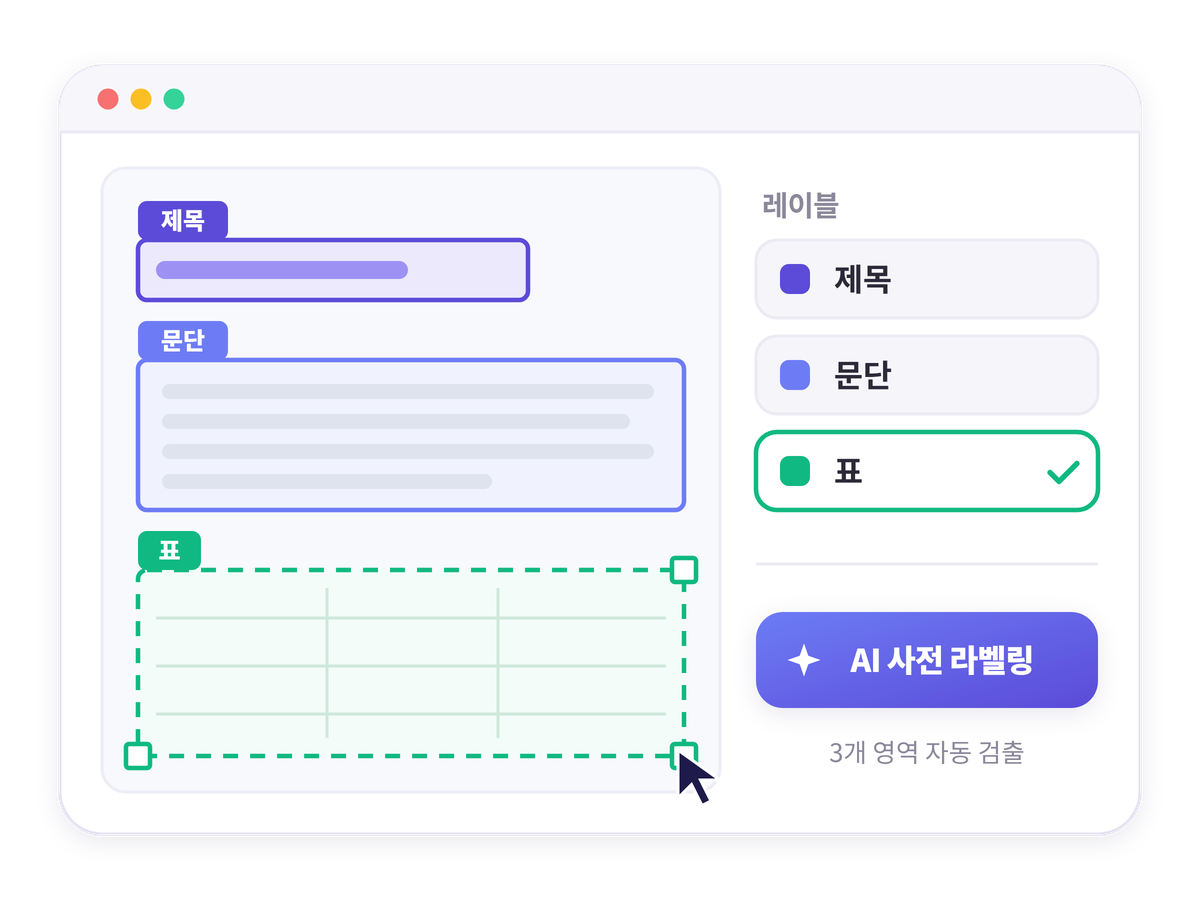
학습 데이터 구축 도구
우리 문서로 학습 데이터를 직접 만드는 라벨링 환경을 제공합니다.
- 문서 위에서 영역을 지정하고 구성 요소 유형 선택
- 읽기 순서 지정
- AI 자동 사전 라벨링으로 초기 작업 단축
- 인식 결과를 확인·수정해 지식 데이터로 적재
-
04
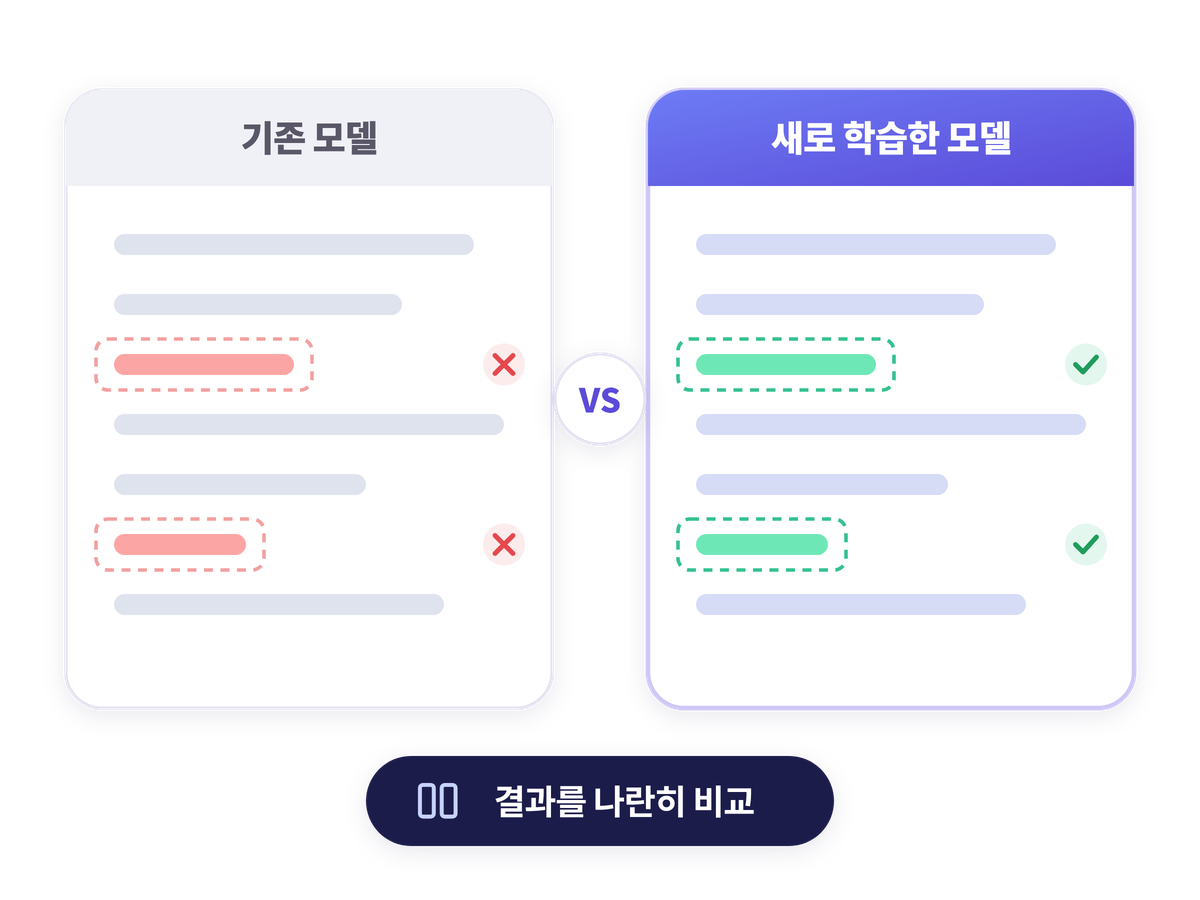
맞춤 모델 학습·비교
개발자가 아니어도 화면에서 모델을 학습시키고 결과를 확인합니다.
- 구축한 데이터로 우리 문서에 맞는 모델 추가 학습
- 레이아웃·텍스트 탐지·텍스트 인식·표 인식 모델을 선택 적용
- 파이프라인 방식과 VLM 방식 중 선택해 문서 파싱
- 두 모델의 결과를 나란히 비교한 뒤 적용
-
05
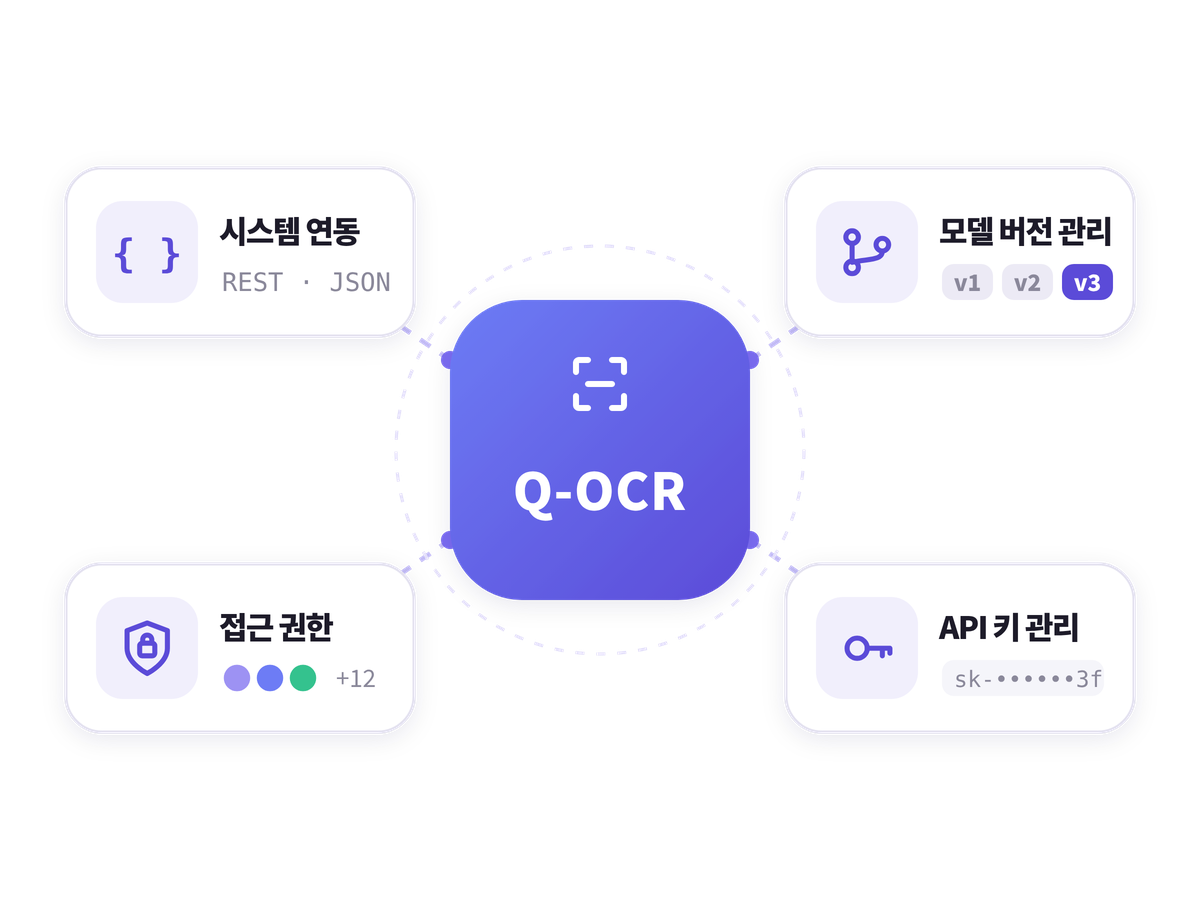
시스템 연동·운영 관리
모델과 서비스를 한 곳에서 관리하고 기존 시스템에 연결합니다.
- API로 기존 업무 시스템과 연동
- 모델 버전 관리와 서비스에 쓸 기본 모델 지정
- 역할 기반 접근 권한과 API 키 관리
USE CASES
Q-OCR은
이렇게 쓰이고 있습니다
한국지능정보원(NIA)과 함께 OCR 학습 데이터 구축 과제를 수행했습니다.
-
고서한자인식
AI 데이터- 고서·고문헌 등 국가기록유산의 한자 이미지 인식
- AI 기반 한자 OCR 기술 개발을 위한 학습 데이터 구축
-
손글씨 및
고서한자 데이터- 다양한 형태의 손글씨 인식을 위한 OCR 학습 데이터 구축
- 산업과 실생활 전반에 적용 가능한 범용성 확보
-
대규모·다중언어
OCR 데이터- 금융권 신청서 필기 정보 OCR 학습 데이터 구축
- 다국어 혼용 문자 인식에 특화된 다중언어 OCR 데이터 구축
FAQ
자주 묻는 질문
Q-OCR 도입을 검토할 때 가장 많이 받는 질문을 모았습니다.
다른 OCR 솔루션과 무엇이 다른가요?
일반적인 OCR은 이미지 속 글자를 문자열로 옮기는 데 그칩니다. Q-OCR은 제목·문단·표·캡션 같은 문서의 구성 요소와 읽기 순서까지 인식해, 구조를 갖춘 데이터로 변환합니다. 인식 결과를 고치는 편집 도구와 학습 데이터 구축 도구를 함께 제공해 우리 문서에 맞게 정확도를 계속 높일 수 있습니다.
어떤 문서 포맷을 지원하나요?
한글, 워드, 파워포인트, 엑셀 등 오피스 문서와 PDF, PNG, JPG 등 이미지 문서를 지원합니다. 스캔한 문서도 이미지 분석으로 처리합니다.
표와 그림이 섞인 문서도 처리되나요?
제목, 문단, 머리글, 바닥글, 캡션, 목차, 표 등 레이아웃을 인식하고 읽기 순서를 함께 구성합니다. 표는 행·열 구조와 병합 셀을 인식해 텍스트 인식 결과와 결합한 뒤 HTML로 변환하므로, 별도 가공 없이 데이터베이스 구축이나 업무 자동화에 활용할 수 있습니다.
우리 문서에 맞게 정확도를 올릴 수 있나요?
가능합니다. 학습 데이터 구축 도구로 대상 문서에 특화된 데이터를 만들고 모델을 추가 학습시킬 수 있습니다. 레이아웃 인식, 텍스트 탐지, 텍스트 인식, 표 인식 모델을 문서 환경에 맞게 선택 적용해 정확도를 높입니다.
개발자가 아니어도 학습시킬 수 있나요?
Q-OCR에서 쓰는 모델은 하나의 시스템에서 화면으로 학습·관리·테스트할 수 있습니다. 라벨링 단계에서는 AI 자동 사전 라벨링이 초기 작업을 대신하고, 학습한 모델은 기존 모델과 결과를 나란히 비교한 뒤 적용할 수 있습니다.
RAG·LLM 구축에 어떻게 연결하나요?
문서에서 구조와 텍스트를 추출한 뒤, 지식 편집 도구로 변환 내용을 확인·수정해 지식 데이터를 구축합니다. Markdown으로 구조화된 결과는 RAG 답변, LLM 학습·추론, 대화형 AI 문답, 업무 자동화, 데이터베이스 구축에 바로 활용됩니다. 다이퀘스트의 AI 검색 솔루션 Q-RAG도 Q-OCR로 문서를 인식합니다.
품질 인증을 받았나요?
Q-OCR은 한국정보통신기술협회(TTA)의 소프트웨어 품질 인증인 GS인증 1등급을 받았습니다.