WHY Q-RAG
Q-RAG의
특별함
Q-RAG의 품질은 네 가지에서 나옵니다.
-
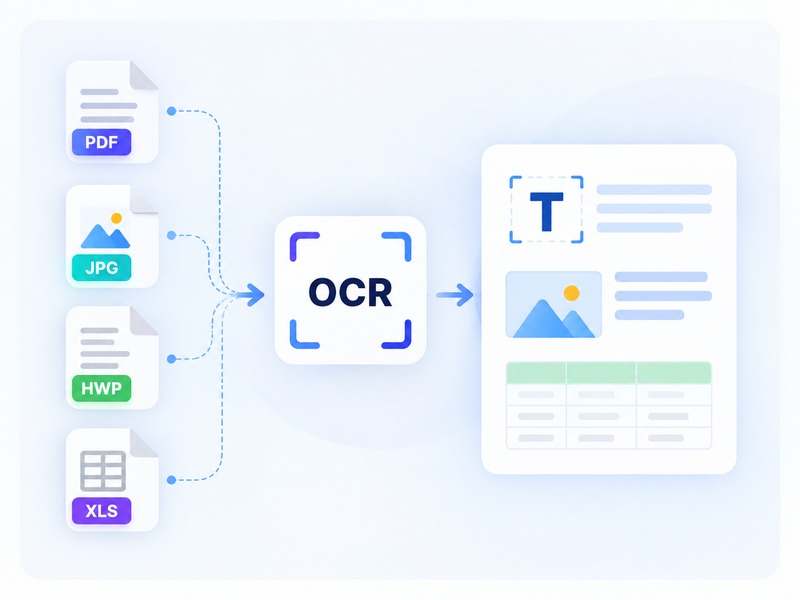
01
문서를 정확하게 읽는 기술
정확한 문서 인식이
정확한 답변으로스캔 문서와 이미지, 오피스·한글(HWP) 문서를 Q-OCR로 읽어 레이아웃과 표까지 인식합니다. 정확하게 읽은 문서가 정확한 답변의 바탕이 됩니다.
-
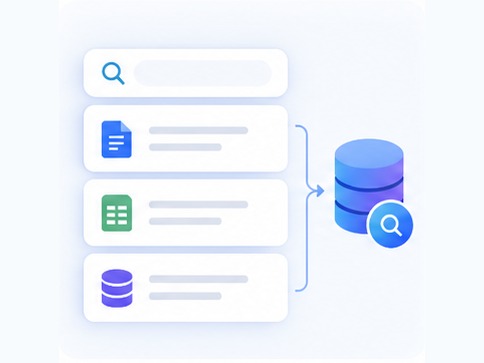
02
지식을 직접 고치고 관리하는 도구
쌓인 문서를
바로 답하는 지식으로인식한 내용은 지식 저장소에 쌓이고, 화면에서 바로 조회·편집·공유합니다. 고친 지식이 그대로 답변에 반영됩니다.
-
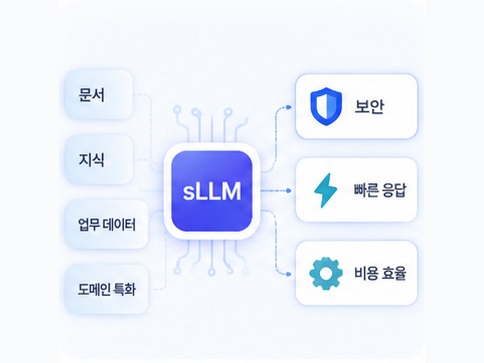
03
업무에 맞춰 다듬은 자체 LLM
업무 목적에 맞게 최적화하고
가볍게 운영하는 모델업무 데이터와 도메인 지식으로 다듬은 자체 sLLM을 씁니다. 보안을 지키면서 빠르게 답하고, 운영 비용도 줄입니다.
-
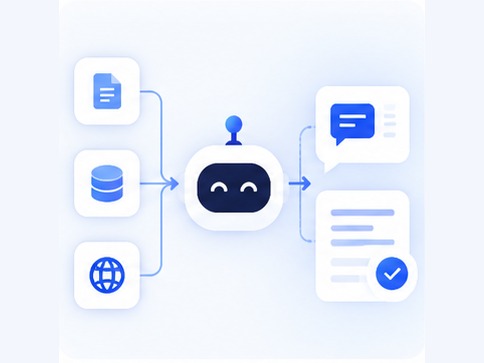
04
하나로 이어진 구성
문서 인식부터 답변 생성까지
한 흐름으로 연결된 RAG문서 인식, 지식 관리, 검색, 답변 생성을 각기 다른 제품으로 잇지 않습니다. 모두 다이퀘스트 자체 기술이라 단계 사이에서 품질이 새지 않습니다.
ARCHITECTURE
기술 구성도
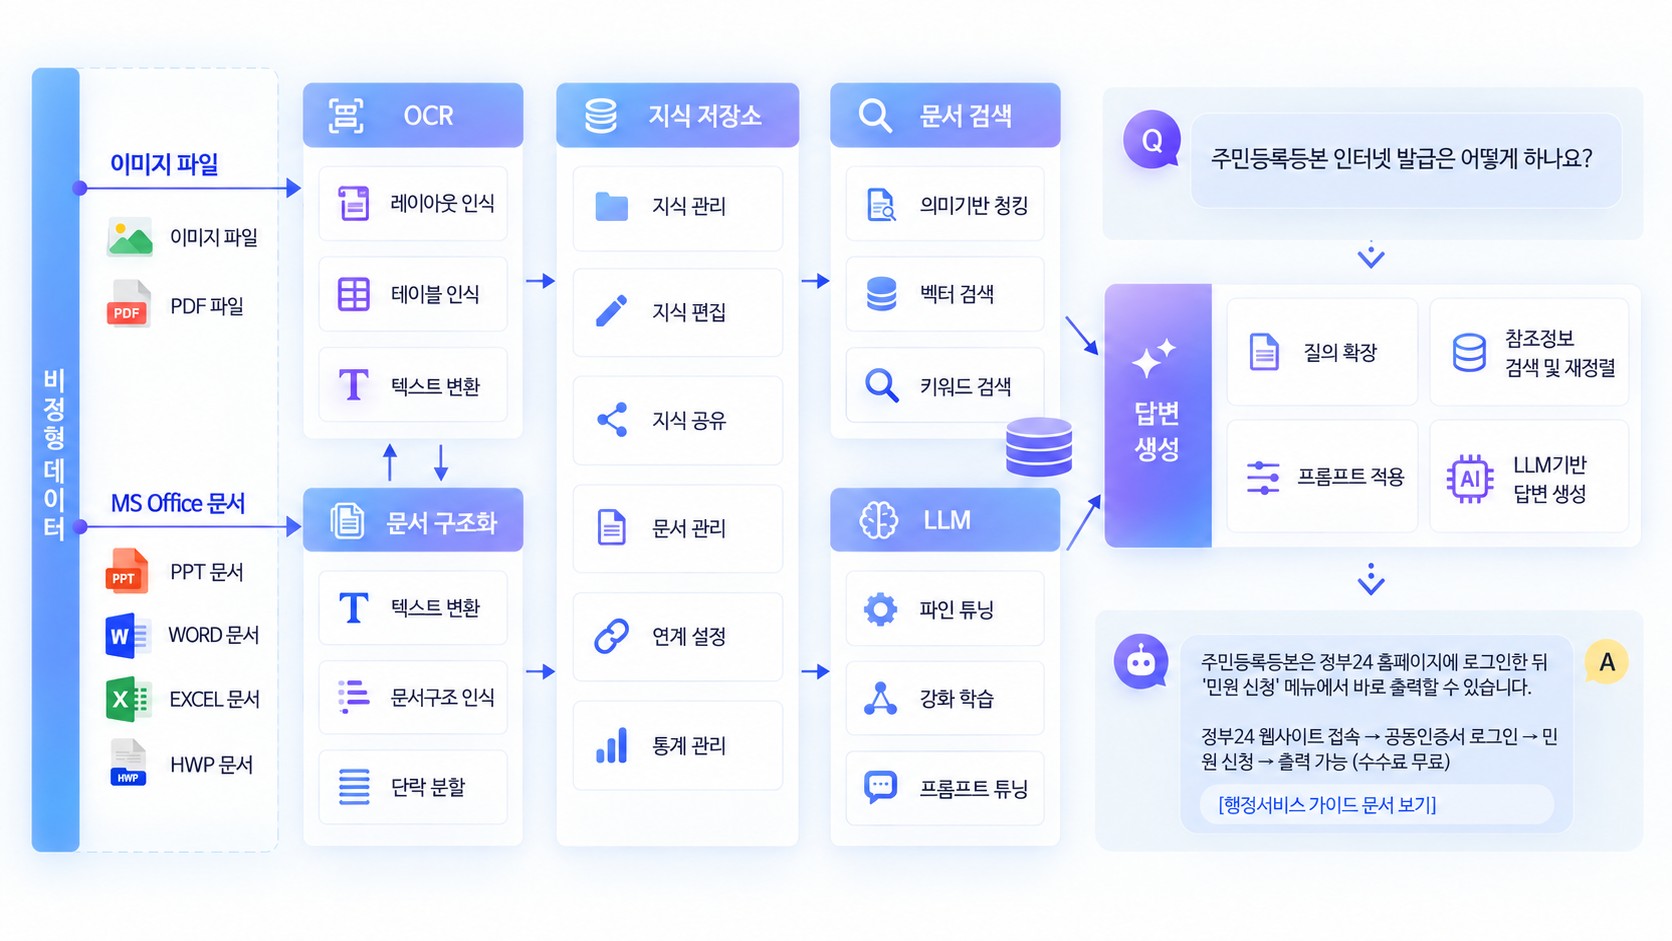
비정형 데이터를 지식으로, 지식을 답변으로. 스캔 문서와 이미지, PPT·Word·Excel·한글(HWP) 문서를 읽어 구조를 인식하고 지식 저장소에 쌓습니다. 질문이 들어오면 벡터 검색과 키워드 검색으로 근거를 찾고, LLM이 그 근거로 답변을 만듭니다.
FEATURES
주요 기능
문서 인식부터 지식 관리, 검색, 답변 생성까지 RAG의 모든 단계를 갖췄습니다.
-
01
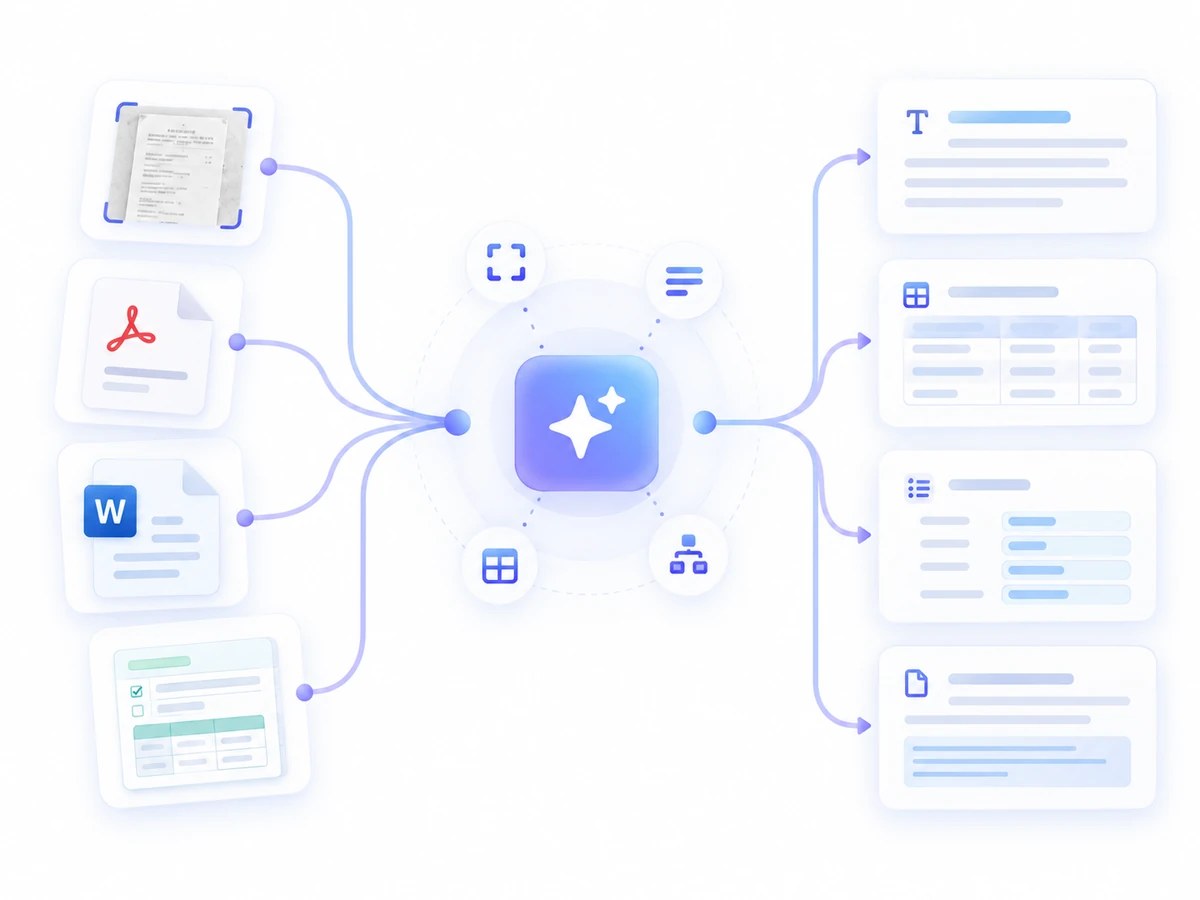
다양한 문서 포맷 지원
복잡한 변환 과정 없이, 어떤 문서든 원클릭으로 깔끔한 텍스트로 추출합니다.
- 이미지 파일 OCR을 통한 레이아웃·테이블 인식, 텍스트 변환
- 오피스·한글(HWP) 문서의 텍스트 변환·문서 구조 인식·단락 분할
- PDF·Word·이미지 등 스캔 문서도 OCR로 정확하게 텍스트화
-
02
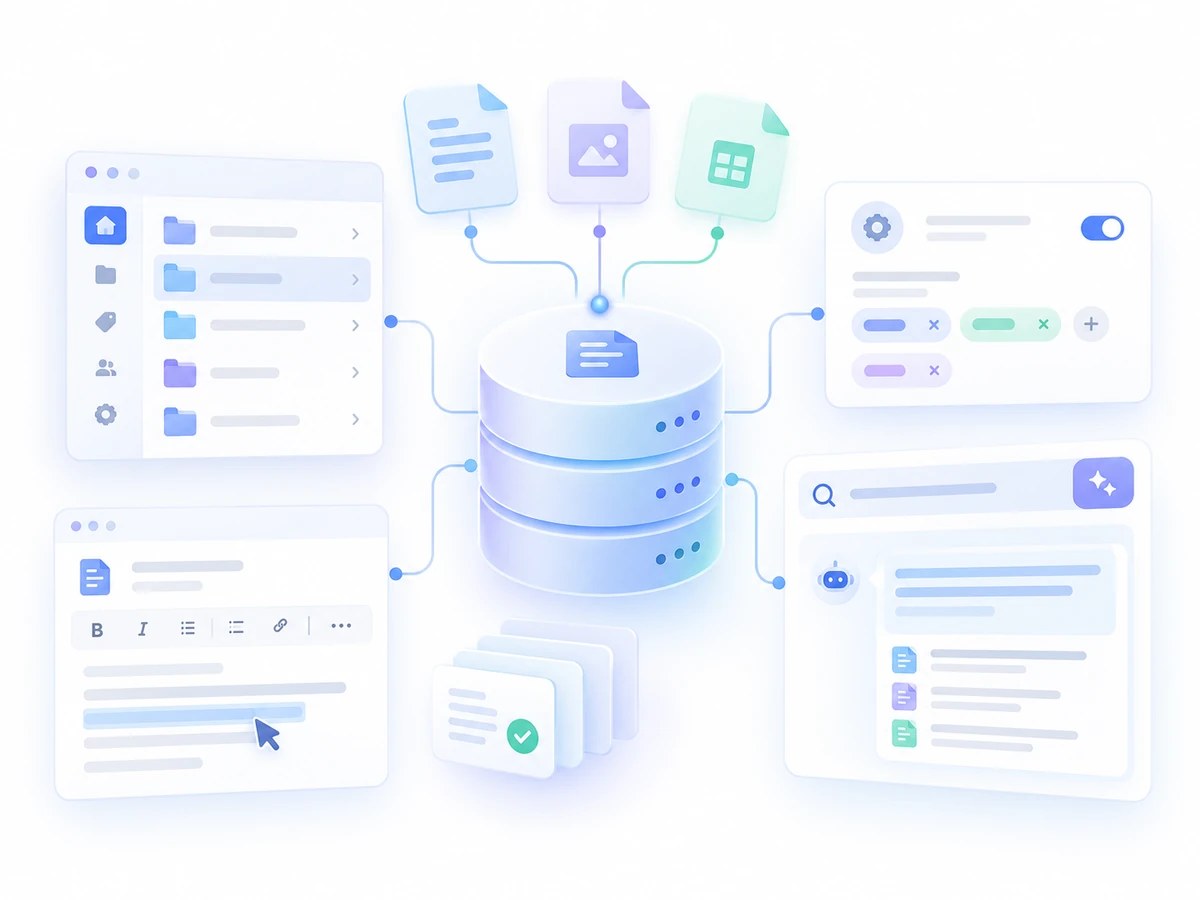
지식 저장소 및 관리 도구
지식 저장소에 데이터를 저장하고, 필요한 대로 직접 가공·편집합니다.
- 지식 관리·편집·공유·문서 관리·연계 설정·통계 관리
- 쌓인 데이터를 화면에서 바로 조회하고 관리·편집
- 구축한 지식 저장소 데이터 기반의 RAG 답변 출력
-
03
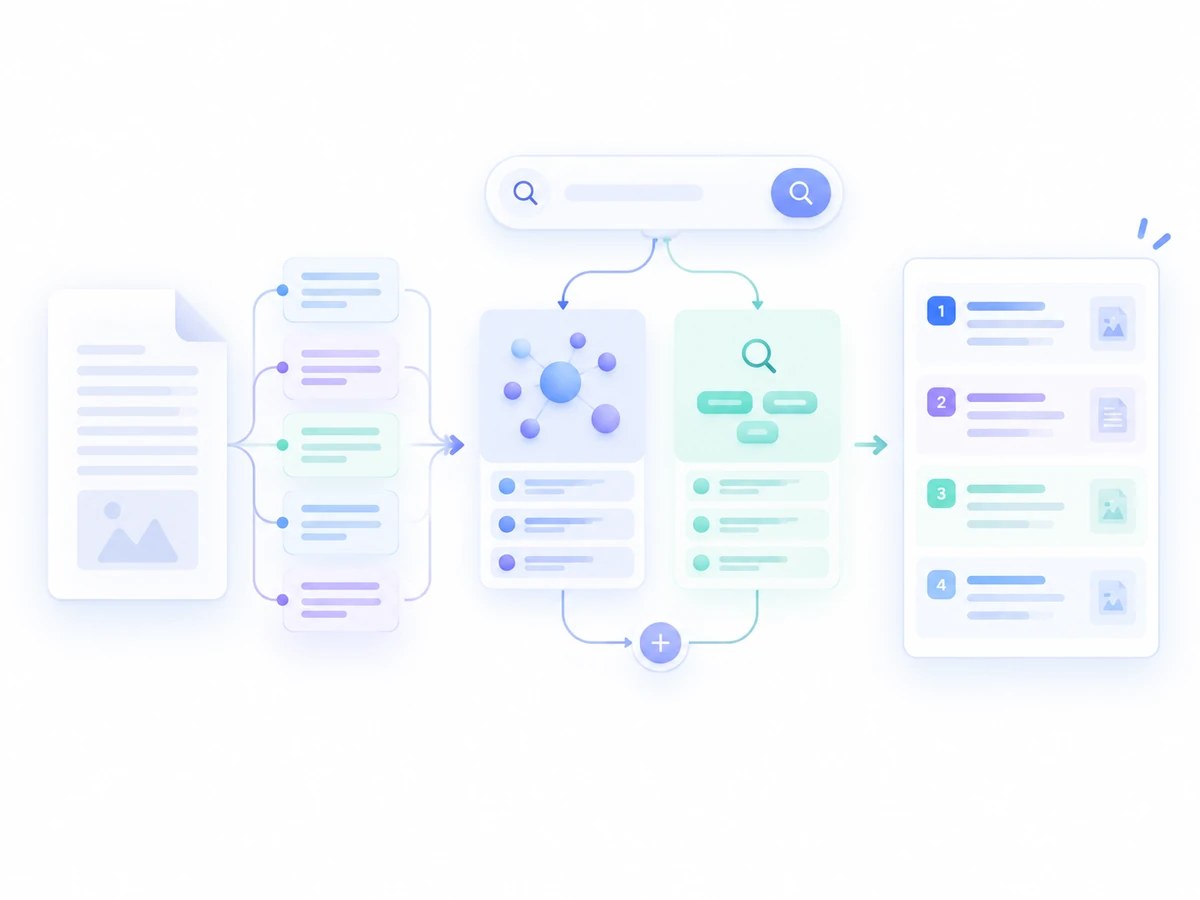
의미 기반 청킹 및 하이브리드 검색
키워드 검색과 벡터 검색 결과를 재정렬해 정확하고 관련성 높은 정보를 찾습니다.
- 목차 단위 청킹과 오버랩 청킹으로 문장 의미 유지
- 벡터 검색과 키워드 검색 결과를 재정렬하는 하이브리드 검색
- 정확도와 관련성이 높은 정보 결과 제공
-
04
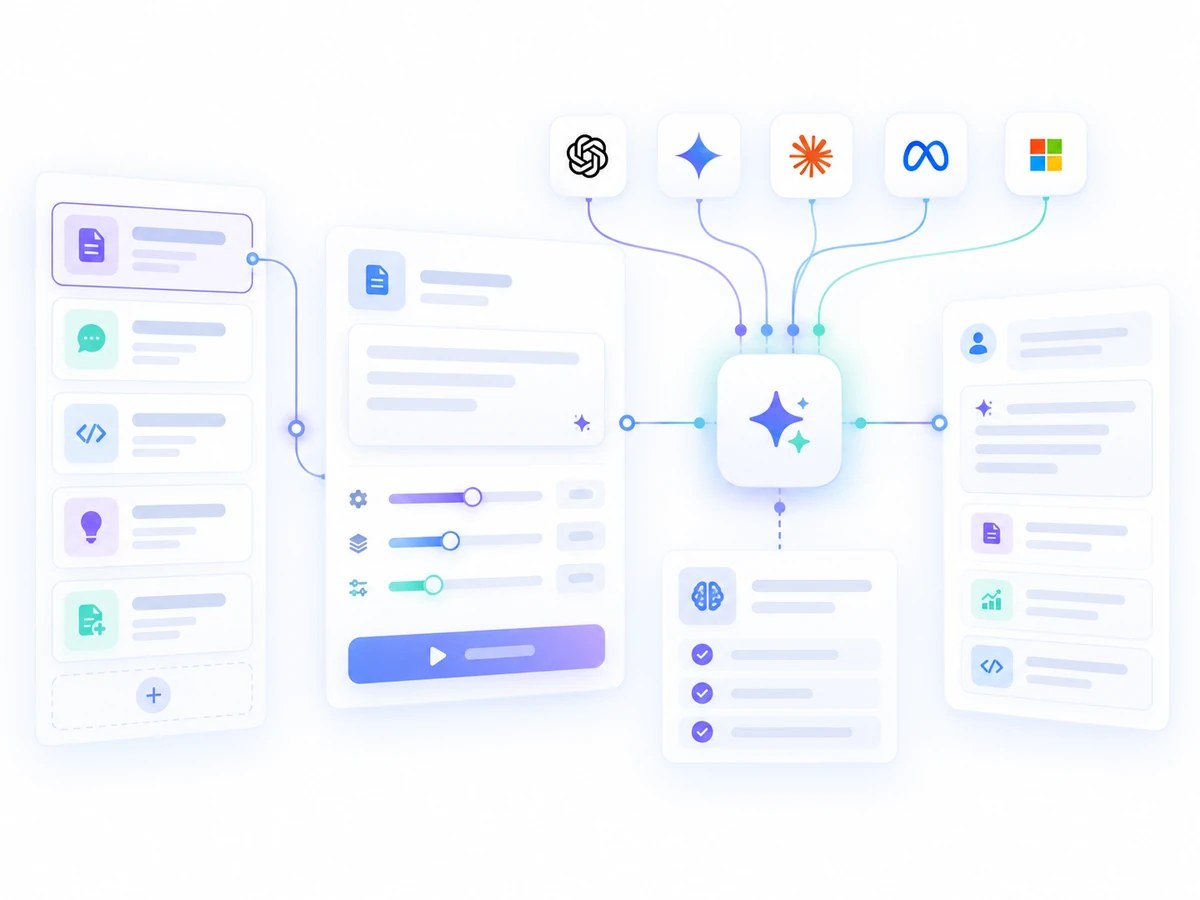
LLM 및 프롬프트 관리
원하는 유형의 답변을 유도하고, 각종 LLM과 유연하게 연계합니다.
- 파인튜닝·강화학습·프롬프트 튜닝
- 질의 확장, 참조 정보 검색·재정렬, 프롬프트 생성, LLM 기반 답변 생성
- 상용·오픈소스 LLM과 자체 학습 모델 연계
-
05
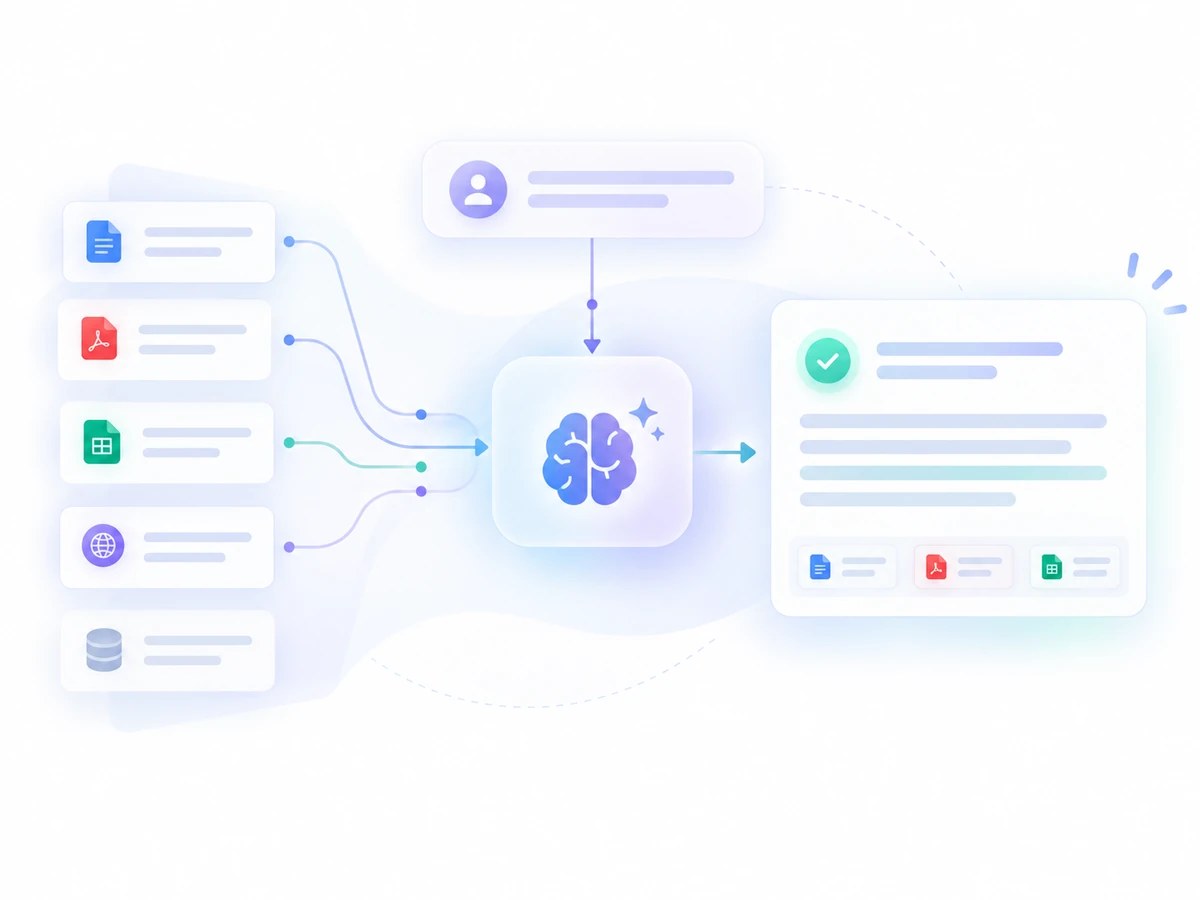
하이브리드 답변 시스템
RAG 기반 답변과 정제 답변을 결합해 신뢰도 높은 응답을 제공합니다.
- 비정형 데이터를 구조화해 지식 저장소에 통합
- 답변의 근거가 되는 데이터 정보와 요약 함께 제시
- 대화 맥락 유지와 유사 질문 제시로 탐색 경험 강화
USE CASES
Q-RAG는
이렇게 쓰이고 있습니다
보안 요건이 엄격한 공공 현장에서 근거 있는 답변으로 운영 중인 사례입니다.
-
한수원형
생성형 AI 구축- 성과
- 생성형 AI의 핵심인 의미 검색 기술을 구현했습니다. 도메인 데이터로 벡터 모델을 튜닝해 맞춤형 검색을 만들고, 리랭킹 모델로 검색 정확도를 극대화했습니다.
-
인공지능 기반 One-Stop
법률구조서비스 플랫폼- 성과
- 문장형 질문만으로 복잡한 법률 용어 정보를 탐색하고, 법적 근거와 출처 정보를 함께 제시해 신뢰도 높은 답변을 지원합니다.
-
AI 기반
범죄수사 지원- 성과
- 범죄수사 죄종별 특화 sLLM을 구축하고 학습 데이터·수사 자료를 구조화해 ‘수사결과 보고서’ 작성을 지원합니다.
FAQ
자주 묻는 질문
Q-RAG 도입을 검토할 때 가장 많이 받는 질문을 모았습니다.
Q-RAG는 어떤 제품인가요?
복잡한 질문도 맥락까지 이해하고 대화하듯 답하는 생성형 AI 검색 솔루션입니다. 비정형 문서를 구조화해 지식 저장소에 통합하고, 하이브리드 검색과 근거 기반 답변으로 기업 내부 지식을 쉽고 정확하게 탐색할 수 있습니다.
어떤 문서 포맷을 지원하나요?
PDF, Word, Excel, PPT, HWP 등 오피스 문서와 이미지 파일을 지원합니다. Q-OCR로 레이아웃·테이블을 인식해 텍스트로 변환하며, 스캔 문서나 이미지 파일도 OCR 기술로 정확하게 텍스트화합니다.
환각(할루시네이션) 문제는 어떻게 줄이나요?
모든 답변을 실제 문서에 근거해 생성하고, 답변의 근거가 되는 데이터 정보를 함께 제시합니다. 벡터·키워드 하이브리드 검색과 재정렬로 관련성 높은 근거를 확보해 신뢰도와 투명성을 높입니다.
어떤 LLM과 연계할 수 있나요?
각종 상용·오픈소스 LLM 및 다이퀘스트가 자체 학습한 모델과 유연하게 연계할 수 있습니다. 파인튜닝·강화학습·프롬프트 튜닝을 통해 특정 도메인 업무에 맞게 최적화할 수 있습니다.
기존 사내 시스템과 연동되나요?
KMS 및 기간계 시스템과 연계하고, 외부 문서·이미지를 크롤링해 정형 데이터를 기반으로 검색할 수 있습니다. 다양한 정보 소스를 활용해 통합된 검색 경험을 제공합니다.
온프레미스 구축이 가능한가요?
가능합니다. 개인정보 보호 및 유출 방지를 위한 구축형 RAG 솔루션으로, 보안 요건이 엄격한 공공·금융 환경에 맞춰 독립형으로 운영할 수 있습니다.
근거와 출처를 함께 제시하는
신뢰할 수 있는 답변
공공·금융 규정에
부합하는 보안 환경
지식 탐색 시간 단축으로
업무 효율 향상